基于Spark与NoSQL的实时数据处理实践 构建高效数据处理服务
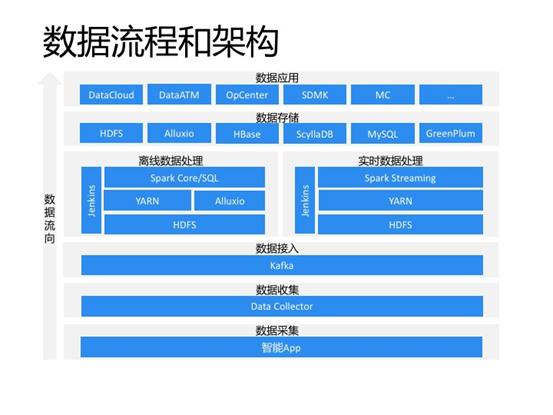
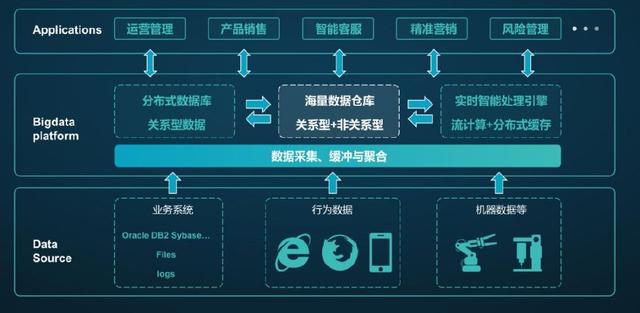
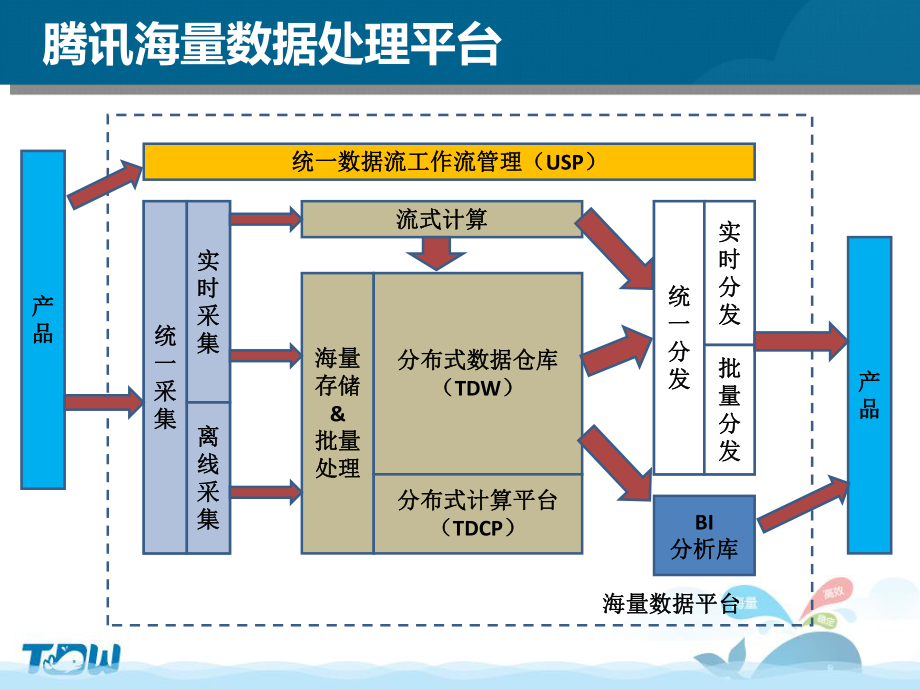
引言\n\n在当今数据驱动的时代,实时数据处理已成为企业获取竞争优势的关键能力。面对源源不断的海量数据流,传统批处理架构难以满足低延迟、高吞吐的需求。Apache Spark以其强大的内存计算和流处理能力,结合NoSQL数据库的灵活性与可扩展性,为构建实时数据处理服务提供了理想的解决方案。本文将分享基于Spark与NoSQL的实时数据处理实践,涵盖架构设计、技术选型、关键实现与优化策略,旨在为读者提供可落地的参考。\n\n## 1. 实时数据处理服务架构\n\n一个典型的实时数据处理服务架构可分为数据采集、消息缓冲、流处理、存储与服务层。如图1所示(此处省略示意图),数据源(如日志、传感器、业务事件)通过采集工具(如Flume、Kafka Producer)写入消息队列(如Kafka);Spark Streaming或Structured Streaming消费Kafka数据,进行实时ETL、聚合、挖掘;处理结果写入NoSQL数据库(如HBase、Cassandra、MongoDB)以支持高并发读写;最终通过API服务或可视化平台对外提供数据服务。\n\n- 数据采集层:负责从多样化的数据源收集数据,并保证数据的可靠传输。\n- 消息缓冲层:使用Kafka实现削峰填谷、解耦生产与消费,保证数据不丢失。\n- 流处理层:Spark Streaming/Structured Streaming提供Exactly-Once语义,支持事件时间窗口、水位线等高级特性。\n被称为流处理引擎,负责实时计算与转换。\n- 存储层:NoSQL数据库根据读写模式选择,如HBase适合海量稀疏数据随机读写,Cassandra擅长高可用写入,MongoDB文档模型灵活。\n- 服务层:通过RESTful API、GraphQL或数据订阅等方式提供实时数据查询与分析结果。\n\n## 2. 技术选型与考量\n\n### 2.1 Spark流处理框架\n\nSpark提供两种流处理API:Spark Streaming(基于微批)和Structured Streaming(基于连续处理模型,但底层仍为微批,支持连续模式)。Structured Streaming以DataFrame API为核心,支持事件时间、水位线、流批一体,简化了开发且性能优异。实践中推荐使用Structured Streaming,其与Spark SQL无缝集成,便于复杂事件处理。\n\n### 2.2 NoSQL数据库选型\n\nNoSQL数据库种类繁多,需根据数据模型、读写QPS、延迟要求、一致性需求进行选择:\n\n- HBase:基于HDFS,适合海量数据随机实时读写,强一致性,但依赖Hadoop生态。\n经常用于存储明细数据或维度数据。\n- Cassandra:去中心化架构,高可用、高写入吞吐,最终一致性,适合时序数据、消息类数据。\n- MongoDB:文档模型灵活,二级索引丰富,适合半结构化数据存储与查询。\n- Redis:内存数据库,亚毫秒级延迟,适合缓存与实时指标存储。\n\n在本实践中,我们采用HBase存储原始明细与维度数据,Cassandra存储时序指标,Redis缓存热点数据,形成多级存储体系。\n\n## 3. 实时数据处理实践\n\n### 3.1 数据采集与接入\n\n使用Filebeat/Logstash采集日志,通过Kafka Producer写入Kafka主题。为保证数据顺序与可靠性,采用Key-based分区,并设置acks=all。\n\n### 3.2 Spark Streaming处理逻辑\n\n以Structured Streaming为例,从Kafka读取数据流:\n\n`scala\nval df = spark.readStream\n .format(\
如若转载,请注明出处:http://www.henandingcan.com/product/54.html
更新时间:2026-11-21 15:09:13